Cómo hacer un video UGC de producto con la Google Flow API
8 min de lectura • 4 de septiembre de 2026 (6 de noviembre de 2026)
useapi.net es una API de terceros. No está afiliada a Google ni cuenta con su respaldo.
Índice
- Introducción
- Precios
- Sobre los ids en las solicitudes
- Paso 1: una ficha por producto
- Paso 2: la presentadora
- Paso 3: la imagen fija, toda la escena en un fotograma
- Paso 4: un clip por producto, todos desde la imagen fija
- Paso 5: escalar a 1080p
- Paso 6: unirlos
- Qué esperar
- Cuánto costó
- Ejecútalo tú mismo
- Preguntas frecuentes
- Conclusión
Introducción
Un video UGC de producto se puede hacer de principio a fin con la Google Flow API de useapi.net por 45 créditos de Flow, sin procesar nada en tu computadora. Una presentadora inventada muestra tres productos inventados a la cámara.
UGC es el estilo de contenido generado por usuarios que llena los feeds de redes sociales y las bibliotecas de anuncios: una persona que le habla a la cámara del celular, para vender un producto, para entretener o solo por diversión.
Esta es la guía completa, de la A a la Z, para producir ese tipo de video a nivel profesional: los productos, la presentadora, sus diálogos y el corte final, todo bajo tu control, en seis pasos de llamadas a la API que puedes copiar tal cual. ¿Prefieres un formulario sin código? El flujo de anuncios UGC en n8n (en inglés) crea este tipo de anuncio con una página para elegir o volver a generar en cada paso.
Este es el resultado: tres clips Omni 1.1 Flash de 10 segundos escalados a 1080p, con cada fotograma y cada sonido generados con la Google Flow API. La misma llamada de escalado llega a 4K cuando necesitas calidad profesional, consulta el Paso 5:
45 créditos en total
Si prefieres ver en lugar de leer, aquí está toda la guía en 75 segundos (en inglés):
ver en YouTube · narración y música de la MiniMax API
Precios
El video con Omni 1.1 Flash requiere una suscripción paga de Google AI (Plus, Pro o Ultra), y useapi.net no cobra nada por video. Lo que costó este video, paso a paso, está en Cuánto costó, y el precio por video en cada plan, frente a la API oficial, está en la tabla de precios de Google Flow.
Sobre los ids en las solicitudes
Cada solicitud de abajo se refiere a resultados anteriores por su mediaGenerationId. Los ids son largos, así que aquí aparecen abreviados como user:1234-email:…-image:b0bdf3e8-…, y una línea debajo de cada solicitud indica a qué resultado anterior corresponde cada uno. El id de una imagen viene de POST /images en media[0].image.generatedImage.mediaGenerationId, el de un personaje en el campo character de POST /characters, el de un video en media[0].mediaGenerationId del job terminado, y el id de un clip escalado es el id de origen con _upsampled al final.
Paso 1: una ficha por producto
Una ficha de producto es una sola imagen que muestra el objeto desde cuatro lados, para que el modelo tenga el objeto completo y no un ángulo afortunado. POST /images, cuadrada, una solicitud por producto. El prompt describe la cámara de cada panel, porque solo “frente, lado, atrás” dio dos paneles idénticos para la taza y ningún lateral real para el teclado. Un objeto plano como el teclado necesita un panel cenital, uno con forma de cubo no. Sin manos, sin textos, sin logos, para que nada más que el producto se cuele en los clips.
Lo mismo funciona con un producto real. Sube fotos con POST /assets y pasa sus ids como reference_1 a reference_4 en esta solicitud, y el modelo las convierte en una ficha limpia de cuatro paneles. El mismo truco sirve para una ficha de un empaque, un logo o un set.
curl — POST /images (la taza)
curl --location 'https://api.useapi.net/v1/google-flow/images' \
--header 'Authorization: Bearer user:1234-…' \
--form 'email="[email protected]"' \
--form 'aspectRatio="1:1"' \
--form 'count="2"' \
--form 'prompt="Orthographic product-catalog sheet on a plain white background: a matte white ceramic mug with a straight cylindrical body and a clearly visible glowing amber light band around its base, about a finger wide, like a smart heated mug. The sheet is divided into four equal panels by thin grey lines in a 2 by 2 grid. Every panel shows the same single item at exactly the same size, position and lighting, camera at the item'\''s eye level unless stated: top-left: side profile, the handle pointing left and seen edge-on; top-right: view from the handle side, the handle pointing straight at the camera; bottom-left: view from the opposite side, the handle hidden behind the body; bottom-right: three-quarter view from slightly above, the handle to the right. Soft even studio light, photoreal. Object only: no hands, no people, no props, no text anywhere, no captions, no labels, no logo, no packaging."'
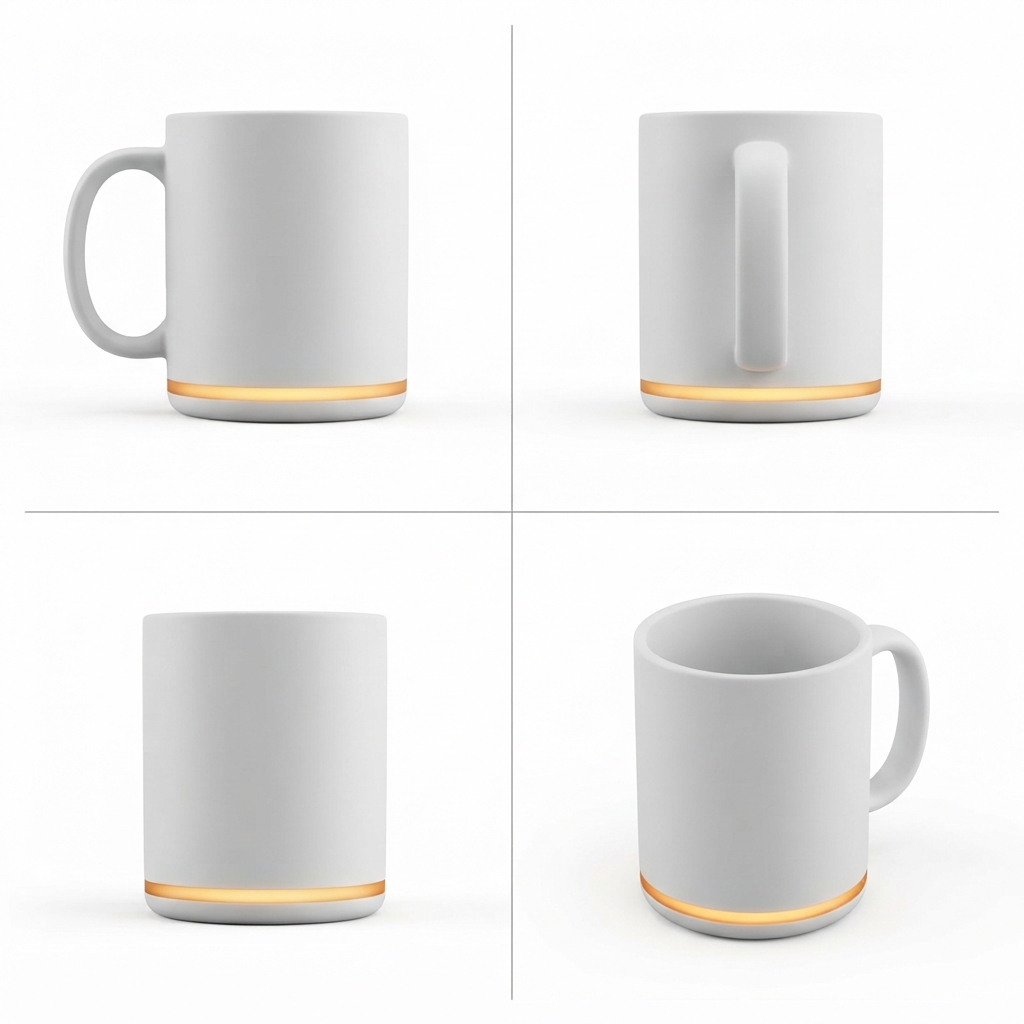
b0bdf3e80 créditos
curl — POST /images (el robot de escritorio)
curl --location 'https://api.useapi.net/v1/google-flow/images' \
--header 'Authorization: Bearer user:1234-…' \
--form 'email="[email protected]"' \
--form 'aspectRatio="1:1"' \
--form 'count="2"' \
--form 'prompt="Orthographic product-catalog sheet on a plain white background: a small rounded pastel mint desk robot, a palm-sized cube with a glossy black screen face showing a happy smiling expression, two round white eyes and a curved white smile, a little rounded antenna nub on top, a small round white dial on its right side, and a speaker grille on its back. The sheet is divided into four equal panels by thin grey lines in a 2 by 2 grid. Every panel shows the same single item at exactly the same size, position and lighting, camera at the item'\''s eye level unless stated: top-left: front view showing the smiling face; top-right: right side view showing the round dial and the antenna nub; bottom-left: back view showing the speaker grille; bottom-right: three-quarter view showing the smiling face and the dial. Soft even studio light, photoreal. Object only: no hands, no people, no props, no text anywhere, no captions, no labels, no logo, no packaging."'
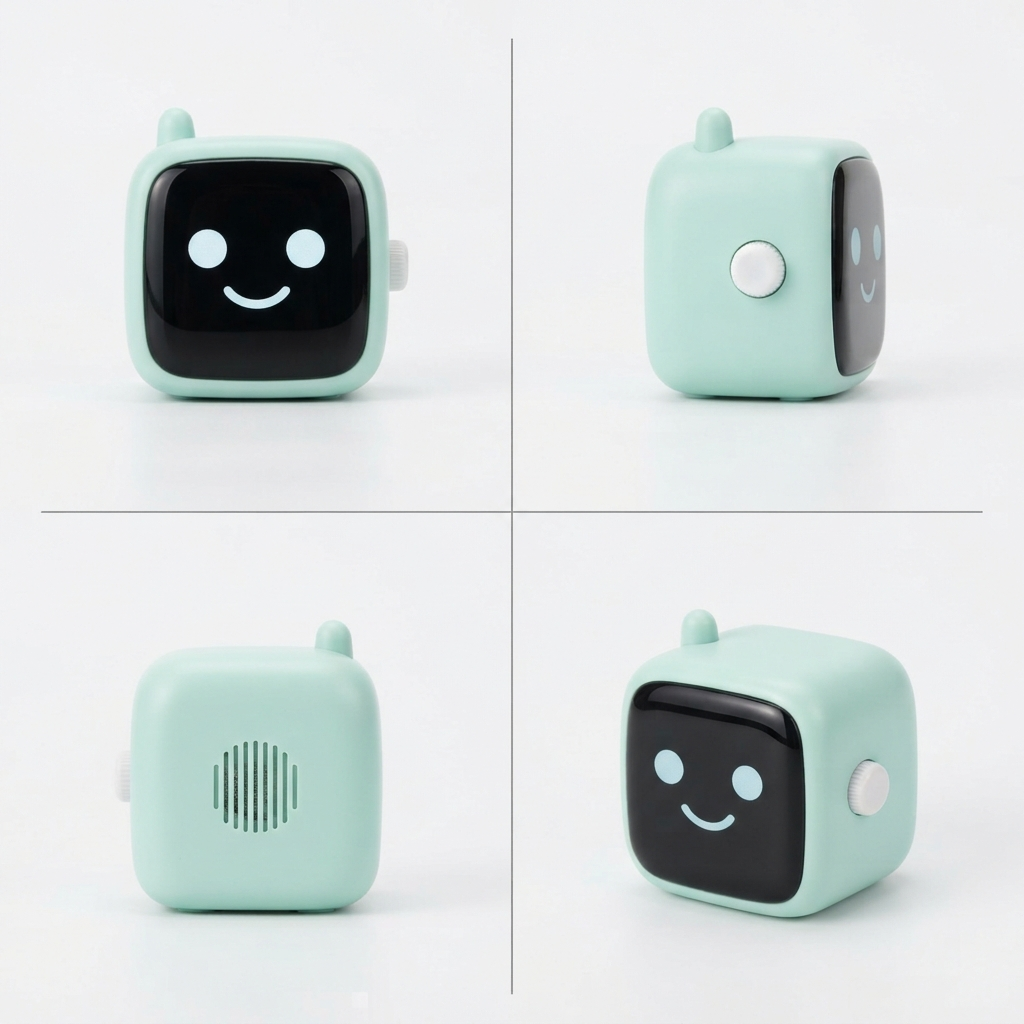
7aaed0560 créditos
curl — POST /images (el teclado)
curl --location 'https://api.useapi.net/v1/google-flow/images' \
--header 'Authorization: Bearer user:1234-…' \
--form 'email="[email protected]"' \
--form 'aspectRatio="1:1"' \
--form 'count="4"' \
--form 'prompt="Orthographic product-catalog sheet on a plain white background: a real mechanical three-key macro pad, the kind sold for shortcuts: a slim, low-profile white aluminum case, three mechanical key switches in one row with sculpted dished keycaps and a small gap between them, coral on the left, lemon yellow in the middle, sky blue on the right, a USB-C port on the back edge. Exactly three keys in one row, never more. The sheet is divided into four equal panels by thin grey lines in a 2 by 2 grid. Every panel shows the same single item at exactly the same size, position and lighting, camera at the item'\''s eye level unless stated: top-left: top-down view straight from above, the three keys in a row left to right; top-right: front view at eye level; bottom-left: left side view at eye level, the slim case and the keycap profile seen edge-on; bottom-right: three-quarter view from above. Soft even studio light, photoreal. Object only: no hands, no people, no props, no text anywhere, no captions, no labels, no logo, no packaging."'
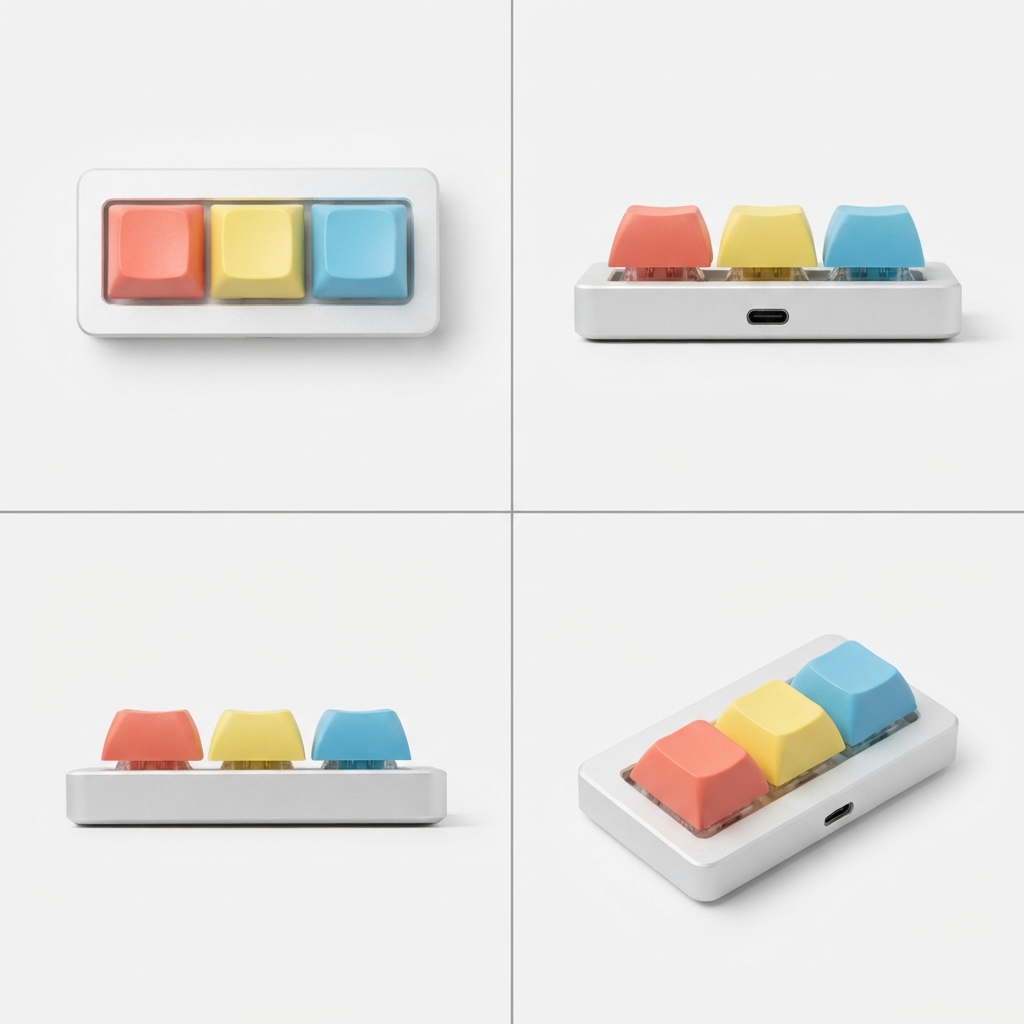
4f861c230 créditos
Las imágenes no cuestan nada, así que pide un count de 2 a 4 y quédate con la mejor ficha. El teclado tomó varias rondas hasta que el prompt describió un macro pad real con un panel cenital, el cubo salió bien a la primera.
Paso 2: la presentadora
Tres llamadas. Un retrato de frente a partir de una descripción. Un retrato de tres cuartos generado a partir del primero con reference_1, para que los dos coincidan en el rostro. Después POST /characters con ambos retratos, que devuelve una referencia de personaje. Desde ese momento ella es @character_1 en cualquier prompt, y Google la fija con su propio sistema de entidades en lugar de con una descripción.
curl — POST /images (retrato de frente)
curl --location 'https://api.useapi.net/v1/google-flow/images' \
--header 'Authorization: Bearer user:1234-…' \
--form 'email="[email protected]"' \
--form 'aspectRatio="3:4"' \
--form 'count="2"' \
--form 'prompt="Character reference portrait, photoreal, natural skin, no heavy retouching: a strikingly attractive young woman in her early twenties with a sleek platinum-blonde blunt bob and straight bangs, dark defined eyebrows, icy grey eyes, a tiny silver nose stud, a playful smirk with a hint of teeth, wearing a fitted black turtleneck and a thin gold chain necklace. Head and shoulders, facing the camera straight on, plain light-grey studio background, soft even light. No text, no logo, no captions."'
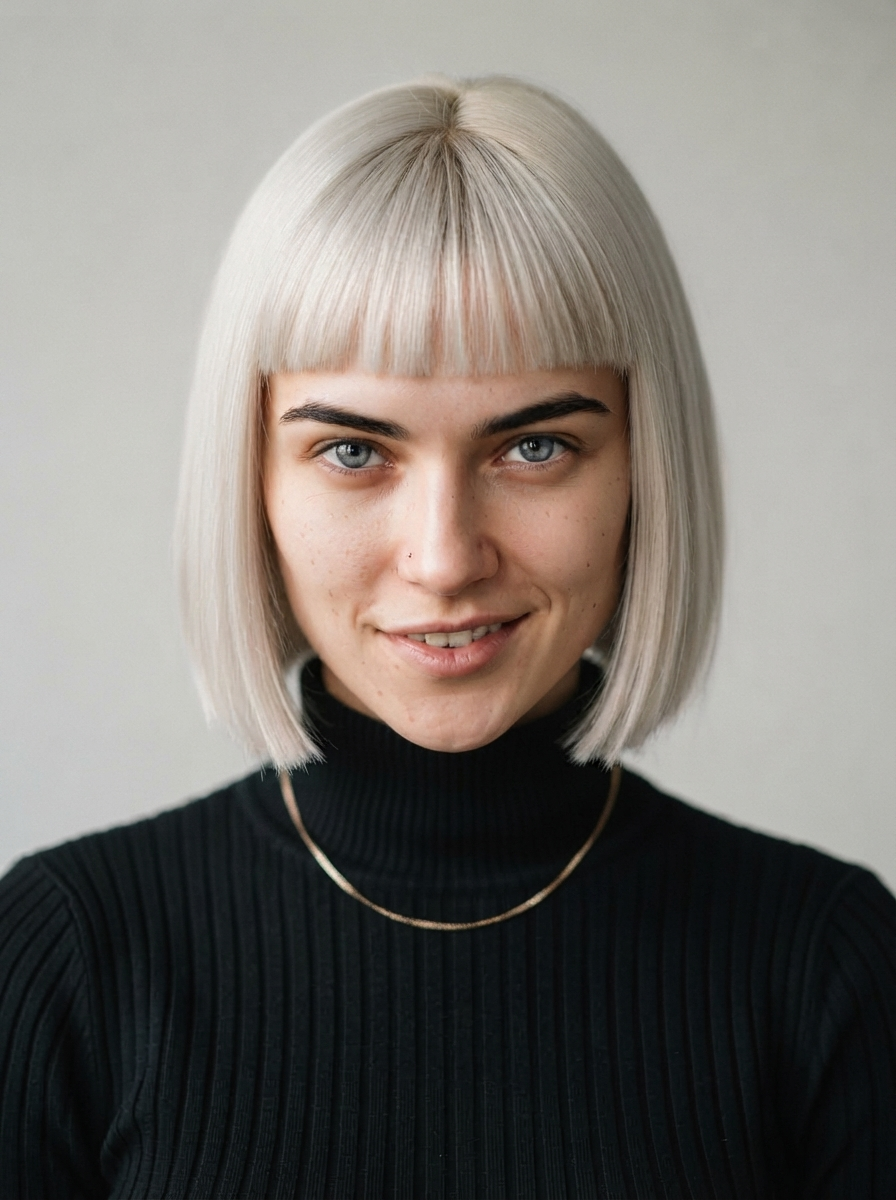
a236ef660 créditos
Generamos varios looks y elegimos este. Si después hay que cambiar un detalle, la cadena, por ejemplo, vuelve a generarla con su propio retrato como reference_1 y un prompt que nombre solo el cambio, y el rostro se mantiene.
curl — POST /images (retrato de tres cuartos)
curl --location 'https://api.useapi.net/v1/google-flow/images' \
--header 'Authorization: Bearer user:1234-…' \
--form 'email="[email protected]"' \
--form 'aspectRatio="3:4"' \
--form 'count="1"' \
--form 'reference_1="user:1234-email:…-image:a236ef66-…"' \
--form 'prompt="@reference_1 is the same woman: identical face, hair, freckles, sweater and earrings. Three-quarter view from the waist up, relaxed natural smile, plain light-grey studio background, soft even light. Photoreal, no text."'
reference_1 es el retrato de frente, a236ef66. Este prompt todavía menciona pecas, un suéter y aretes que quedaron de una presentadora anterior, y no hizo daño: con una imagen de referencia en la solicitud, la referencia gana sobre las palabras.
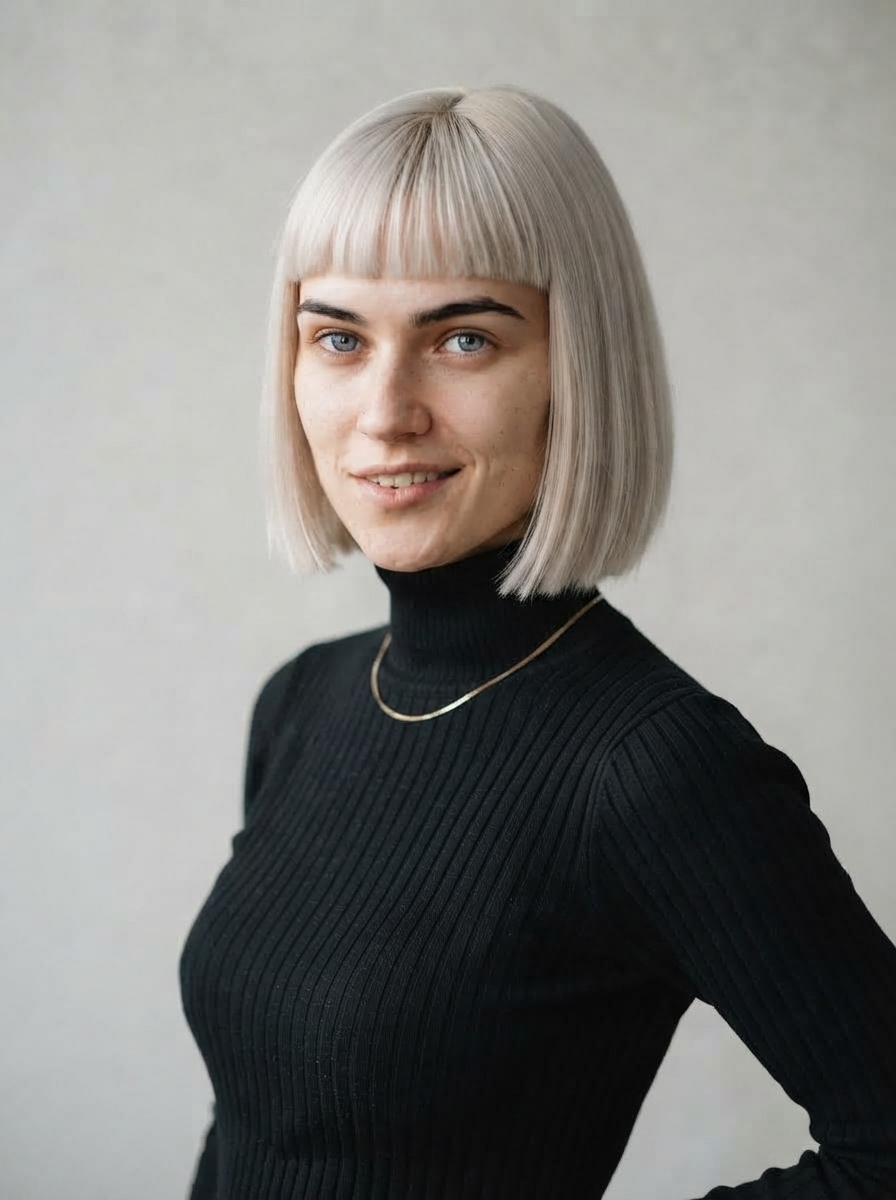
d891301c0 créditos
curl — POST /characters
curl --location 'https://api.useapi.net/v1/google-flow/characters' \
--header 'Authorization: Bearer user:1234-…' \
--form 'displayName="Mia"' \
--form 'personalityNotes="Quick, bright, deadpan delivery with a smile in her voice. Talks to the camera like a friend showing off things she bought at 2am."' \
--form 'imageReference_1="user:1234-email:…-image:a236ef66-…"' \
--form 'imageReference_2="user:1234-email:…-image:d891301c-…"' \
--form 'voice="Leda"'
imageReference_1 es el retrato de frente a236ef66, imageReference_2 el de tres cuartos d891301c. El campo character de la respuesta es su id, 53ca1036 más abajo. La voice es uno de los presets de sistema de Google y viaja con el personaje, pero no llega al modo de clip que se usa en el Paso 4, consulta Qué esperar.
Paso 3: la imagen fija, toda la escena en un fotograma
Una solicitud lo junta todo. El personaje entra como character_1, las tres fichas como reference_1 a reference_3, y el prompt las coloca por etiqueta, de izquierda a derecha sobre la mesa frente a ella. Este fotograma se convierte en los dos extremos de cada clip, así que es el único lugar donde las etiquetas hacen su trabajo.
curl — POST /images
curl --location 'https://api.useapi.net/v1/google-flow/images' \
--header 'Authorization: Bearer user:1234-…' \
--form 'email="[email protected]"' \
--form 'aspectRatio="9:16"' \
--form 'count="2"' \
--form 'character_1="user:1234-email:…-character:53ca1036-…"' \
--form 'reference_1="user:1234-email:…-image:b0bdf3e8-…"' \
--form 'reference_2="user:1234-email:…-image:7aaed056-…"' \
--form 'reference_3="user:1234-email:…-image:4f861c23-…"' \
--form 'prompt="Full-frame vertical phone video look, no phone, no bezel. @character_1 sits at a light wooden table in a bright minimal creator studio, facing the camera, waist-up and centered, a plain warm-grey backdrop behind her, soft key light from the left with a gentle catchlight in her eyes. Laid out on the table in front of her, left to right, each fully visible and resting flat on the table: the mug from @reference_1, the desk robot from @reference_2, the keyboard from @reference_3. Her hands rest on the table, relaxed closed-mouth smile, eyes on the lens. Photoreal, no text, no captions."'
character_1 es el personaje del Paso 2, 53ca1036. reference_1 a reference_3 son las tres fichas del Paso 1: la taza b0bdf3e8, el robot de escritorio 7aaed056, el teclado 4f861c23.
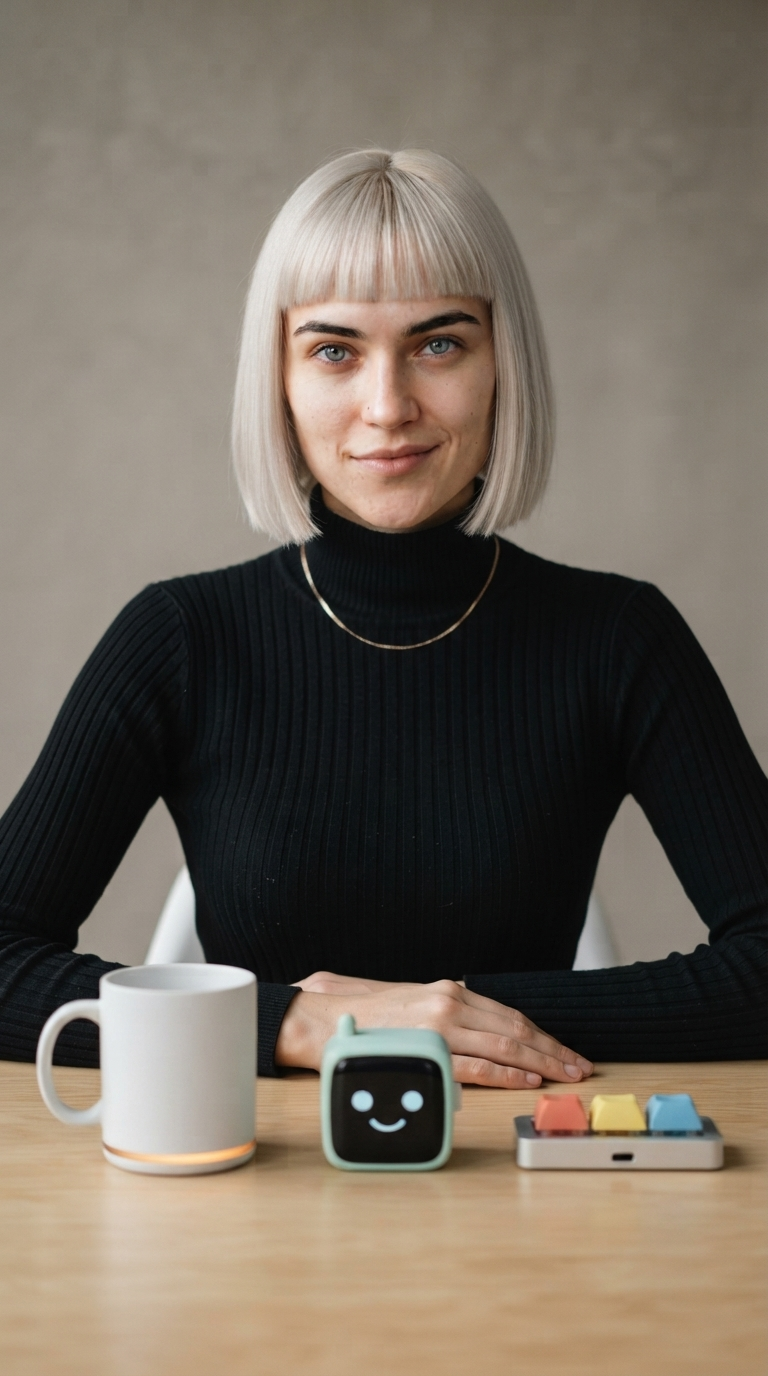
034cddc80 créditos
La taza tiene su brillo, el robot su cara y su antena, el teclado sus tres colores y su puerto, y ella es la mujer de los retratos.
Paso 4: un clip por producto, todos desde la imagen fija
El modo de primer y último fotograma de Omni con la imagen fija en ambas posiciones, una solicitud por producto, el mismo POST /videos cada vez. Este modo solo acepta las dos imágenes, sin fichas, sin personaje, sin referencia de voz. No pasa nada, porque la imagen fija ya lo contiene todo. Cada objeto que ella levanta salió igual a su ficha solo a partir de la imagen fija.
El prompt cumple tres funciones. Fija ambos extremos al fotograma, con una pausa tranquila en cada lado. Le da su diálogo y su voz. Y marca los tiempos de la coreografía: empieza a hablar mientras levanta el objeto, el objeto vuelve a su lugar para el segundo ocho, y los dos últimos segundos son una pausa quieta y en silencio. Sin esa última parte se atrasaba y su brazo saltaba al fotograma final.
curl — POST /videos (la taza)
curl --location 'https://api.useapi.net/v1/google-flow/videos' \
--header 'Authorization: Bearer user:1234-…' \
--form 'email="[email protected]"' \
--form 'model="omni-flash"' \
--form 'aspectRatio="portrait"' \
--form 'duration="10"' \
--form 'resolution="720p"' \
--form 'startImage="user:1234-email:…-image:034cddc8-…"' \
--form 'endImage="user:1234-email:…-image:034cddc8-…"' \
--form 'prompt="She begins and ends exactly on this frame: hands resting on the table, the three items laid out in front of her, a small closed-mouth smile, looking into the lens, with a short quiet beat before she moves and another after she settles back. Timing matters: after a short quiet beat she picks up the mug on the left with both hands and starts talking as she lifts it, holding it up to the camera and talking straight to the lens, quick and bright with a deadpan edge and a smile in her voice, keeping both hands on the mug while she speaks. She says: \"Three gadgets smarter than me. Low bar. One: this mug texts me when my coffee'\''s cold. Better follow-up than my ex.\" Right after the last word she gives one short laugh to herself, still holding the mug. By the eight-second mark the mug is back down gently in exactly the same spot and both hands are resting on the table again, brought back in one calm unhurried movement. For the final two seconds she holds completely still, hands resting on the table, looking into the lens with a small closed-mouth smile. Natural room tone, no music, no captions, no text on screen."'
startImage y endImage son ambos la imagen fija del Paso 3, 034cddc8. Los mismos dos ids van en los tres clips.
55808825, mostrado tras el escalado a 1080p del Paso 515 créditos
curl — POST /videos (el robot de escritorio)
curl --location 'https://api.useapi.net/v1/google-flow/videos' \
--header 'Authorization: Bearer user:1234-…' \
--form 'email="[email protected]"' \
--form 'model="omni-flash"' \
--form 'aspectRatio="portrait"' \
--form 'duration="10"' \
--form 'resolution="720p"' \
--form 'startImage="user:1234-email:…-image:034cddc8-…"' \
--form 'endImage="user:1234-email:…-image:034cddc8-…"' \
--form 'prompt="She begins and ends exactly on this frame: hands resting on the table, the three items laid out in front of her, a small closed-mouth smile, looking into the lens, with a short quiet beat before she moves and another after she settles back. Timing matters: after a short quiet beat she picks up the desk robot in the middle with both hands and starts talking as she lifts it, holding it up to the camera with its smiling face toward the lens and turning it once and talking straight to the lens, quick and bright with a deadpan edge and a smile in her voice, keeping both hands on it while she speaks. The other two items stay on the table exactly where they are. She says: \"Two: a desk robot that reacts to my day. It has a face. It has never once looked impressed.\" Right after the last word she raises one eyebrow at the camera, a quick expressive beat, still holding the desk robot. By the eight-second mark the desk robot is back down gently in exactly the same spot and both hands are resting on the table again, brought back in one calm unhurried movement. For the final two seconds she is silent and holds completely still, hands resting on the table, looking into the lens with a small closed-mouth smile. Natural room tone, no music, no captions, no text on screen."'
c4d0e6b1, mostrado tras el escalado a 1080p del Paso 515 créditos
curl — POST /videos (el teclado)
curl --location 'https://api.useapi.net/v1/google-flow/videos' \
--header 'Authorization: Bearer user:1234-…' \
--form 'email="[email protected]"' \
--form 'model="omni-flash"' \
--form 'aspectRatio="portrait"' \
--form 'duration="10"' \
--form 'resolution="720p"' \
--form 'startImage="user:1234-email:…-image:034cddc8-…"' \
--form 'endImage="user:1234-email:…-image:034cddc8-…"' \
--form 'prompt="She begins and ends exactly on this frame: hands resting on the table, the three items laid out in front of her, a small closed-mouth smile, looking into the lens, with a short quiet beat before she moves and another after she settles back. Timing matters: after a short quiet beat she picks up the keyboard on the right with both hands and starts talking as she lifts it, holding it up to the camera with the three keys facing the lens and talking straight to the lens, quick and bright with a deadpan edge and a smile in her voice, keeping both hands on it while she speaks. The other two items stay on the table exactly where they are. She says: \"Three: a keyboard with three keys. Copy, paste, undo. That'\''s my whole career. Oh, the mug'\''s texting. Bye!\" Right after the last word she raises one eyebrow at the camera, a quick expressive beat, still holding the keyboard. By the eight-second mark the keyboard is back down gently in exactly the same spot and both hands are resting on the table again, brought back in one calm unhurried movement. For the final two seconds she is silent and holds completely still, hands resting on the table, looking into the lens with a small closed-mouth smile. Natural room tone, no music, no captions, no text on screen."'
3cc8ea2f, mostrado tras el escalado a 1080p del Paso 515 créditos
La misma mujer, la misma mesa, la misma luz, y cada clip abre y cierra en la imagen fija, así que cualquiera puede ir después de cualquier otro. Los diálogos tienen unas 20 palabras en inglés, lo que cabe en 10 segundos a este ritmo con espacio para la pausa del final.
Paso 5: escalar a 1080p
Omni 1.1 Flash renderiza en 720p. POST /videos/upscale lleva un clip a 1080p gratis en cualquier plan pago, en unos 40 segundos, y responde en la misma llamada con el id y la URL del clip escalado. Una solicitud por clip, sin email: la cuenta sale del id.
curl — POST /videos/upscale (la taza, luego lo mismo para los otros dos)
curl --location 'https://api.useapi.net/v1/google-flow/videos/upscale' \
--header 'Authorization: Bearer user:1234-…' \
--form 'mediaGenerationId="user:1234-email:…-video:55808825-…"' \
--form 'resolution="1080p"'
mediaGenerationId es el clip de la taza del Paso 4, 55808825. La misma llamada con c4d0e6b1 y 3cc8ea2f escala el robot y el teclado. Cada respuesta trae el nuevo clip en media[0].mediaGenerationId, que es el id de origen con _upsampled al final, así que los tres ids escalados son 55808825-…_upsampled, c4d0e6b1-…_upsampled y 3cc8ea2f-…_upsampled. Los clips que se muestran en el Paso 4 son estas versiones escaladas. También hay 4K, por 50 créditos y solo en un plan Google AI Ultra.
Paso 6: unirlos
POST /videos/concatenate recibe los tres ids escalados en orden y devuelve el archivo unido en base64, a la resolución de los clips. Los recortes deciden si las uniones se sienten como una sola toma. Cada clip abre con una pausa corta en la imagen fija y cierra regresando a ella, y sin recortar esas pausas se acumulan en un congelamiento en cada corte. Pero ella termina cada diálogo con las manos ya apoyadas, así que un recorte medido solo por la imagen se come las últimas palabras. Corta después del último sonido más un instante, nunca antes. En estos clips eso significó dejar el clip 1 entero, ya que su risa llega hasta el último fotograma, quitar poco más de medio segundo del final del clip 2 y unos cuantos fotogramas del inicio de los clips 2 y 3.
curl — POST /videos/concatenate
curl --location 'https://api.useapi.net/v1/google-flow/videos/concatenate' \
--header 'Authorization: Bearer user:1234-…' \
--header 'Content-Type: application/json' \
--data '{
  "media": [
    { "mediaGenerationId": "user:1234-email:…-video:55808825-…_upsampled" },
    { "mediaGenerationId": "user:1234-email:…-video:c4d0e6b1-…_upsampled", "trimStart": 0.458, "trimEnd": 0.6 },
    { "mediaGenerationId": "user:1234-email:…-video:3cc8ea2f-…_upsampled", "trimStart": 0.125 }
  ]
}'
Los tres ids son los clips escalados del Paso 5, en orden: la taza, el robot de escritorio, el teclado.
0 créditos
Termina un diálogo con las manos en la mesa, llega el corte y ella toma el siguiente objeto. El archivo unido se volvió a codificar a un tamaño menor para alojarlo, los tres clips están tal como los devolvió la API.
Qué esperar
- Genera, no edites. La publicación UGC talking head (en inglés) extendió un clip con ediciones de video a video, y eso todavía funciona cuando los diálogos son cortos. Aquí no funcionó. Una edición mantiene el habla del clip de origen en la propia línea de tiempo del origen, así que con un diálogo de 10 segundos llenando el clip base, el nuevo diálogo se entrelazó con el anterior en lugar de reemplazarlo, y los productos que quedaban en la mesa cambiaron entre tomas. Generar cada clip desde la imagen fija dio diálogos completos, productos intactos y uniones más limpias, por menos créditos.
- La imagen fija lleva las etiquetas. El modo de primer y último fotograma solo acepta las dos imágenes. Haz el etiquetado en la imagen fija, con el personaje y las fichas, y los clips lo heredan.
- Marca los tiempos de la coreografía. Un clip de 10 segundos con un diálogo completo necesita que el momento de dejar el objeto se indique por reloj, “by the eight-second mark” (para el segundo ocho), y una pausa quieta y en silencio al final. Por su cuenta, el modelo alargaba el diálogo y saltaba al fotograma final.
- Describe la voz igual en cada prompt. Nada lleva una voz de un clip a otro, y un personaje puede guardar un preset de voz, pero no llega a este modo. Con una descripción idéntica, los tres clips salieron lo bastante parecidos para pasar por una sola toma.
- Las fichas necesitan cámara por panel. Indica qué muestra cada uno de los cuatro paneles. Dale a los objetos planos un panel cenital. Deja fuera manos, textos y logos, porque lo que esté en la ficha puede terminar en el clip.
- Recorta según el sonido, no la imagen. Ella se queda quieta antes de terminar de hablar. Un corte en el primer fotograma quieto se llevó el final de un diálogo.
- La presentadora es inventada. La moderación de Google es más estricta con personas reales e identificables. Empieza con un personaje generado.
Cuánto costó
| Paso | Modo | Créditos |
|---|---|---|
| Tres fichas de producto, 1:1 | Nano Banana 2 Lite | 0 |
| Dos retratos de la presentadora, 3:4 | Nano Banana 2 Lite | 0 |
| El personaje | — | 0 |
| La imagen fija, 9:16 | Nano Banana 2 Lite, personaje + 3 referencias | 0 |
| Clip 1, la taza, 10s | I2V, primer + último fotograma | 15 |
| Clip 2, el robot de escritorio, 10s | I2V, primer + último fotograma | 15 |
| Clip 3, el teclado, 10s | I2V, primer + último fotograma | 15 |
| Escalado, tres clips a 1080p | — | 0 |
| Concatenar | — | 0 |
| Total | 45 |
Las imágenes, los personajes, el escalado a 1080p y la concatenación no cuestan nada, así que itera libremente las fichas, la presentadora y la imagen fija antes de gastar un crédito en video. El 4K es la única mejora con costo, 50 créditos por clip en Ultra.
Ejecútalo tú mismo
Cada paso de arriba es una llamada a la API, y los seis se encadenan en un script. El pipeline completo en Node.js, una versión en Python y el prompts.json con todos los prompts de esta página están en useapi/google-flow-api/ugc-product-video. Clónalo, pon tus propios productos y diálogos en prompts.json, y un solo comando arma el video completo.
Guarda un punto de control después de cada paso, así que una ejecución interrumpida se reanuda en lugar de volver a pagar los clips, y puedes rehacer un solo paso — una imagen fija mejor, otra presentadora — sin regenerar lo que vino antes.
Preguntas frecuentes
- ¿Puedo usar fotos de mi propio producto en lugar de fichas generadas? Con useapi.net, sí. Súbelas con POST /assets y pasa los ids devueltos como
reference_1areference_3en la imagen fija, exactamente como se pasan aquí las fichas generadas. La ficha de cuatro paneles es una forma de darle al modelo todos los lados de un objeto, y un producto real se beneficia del mismo tratamiento. - ¿Por qué no editar un clip para convertirlo en el siguiente, como en la publicación del talking head (en inglés)? Con useapi.net se puede, pero una edición de video a video mantiene el habla del origen en la línea de tiempo del origen. Con diálogos cortos funciona. Con un diálogo de 10 segundos llenando el clip, el nuevo diálogo se entrelazó con el anterior y los productos de la mesa cambiaron. Generar cada clip desde la misma imagen fija evita ambas cosas y cuesta 15 créditos en lugar de 20. Consulta Qué esperar.
- ¿Por qué los tres clips empiezan y terminan en el mismo fotograma? Con useapi.net, el modo de primer y último fotograma fija ambos extremos de cada clip a la misma imagen fija, así que los clips se unen en cualquier orden sin un corte visible, y la llamada de concatenación recorta las pausas cortas en cada unión. El mecanismo se explica en la publicación UGC talking head (en inglés).
- ¿La voz se mantiene igual entre los clips? Con useapi.net, los tres clips salieron lo bastante parecidos para pasar por una sola toma, porque la voz se describió de forma idéntica en cada prompt. El modo de primer y último fotograma no acepta referencia de audio, y el preset de voz de un personaje no llega a él. Si necesitas una voz garantizada, el modo de referencia a video acepta
referenceAudio_1, a costa de los fotogramas fijados. - ¿Cuánto cuesta? Con useapi.net, este video completo de 29 segundos cuesta US$0,36 en Google AI Ultra US$199,99: 45 créditos de Flow para los tres clips Omni 1.1 Flash, con todas las imágenes, retratos, el personaje y la concatenación gratis. Los mismos 30 segundos de Omni 1.1 Flash a 720p cuestan unos US$3,04 en la Gemini API oficial (a noviembre de 2026). Consulta Cuánto costó.
Conclusión
Visita nuestro  servidor de Discord o nuestro
 canal de Telegram para cualquier pregunta de soporte.
Consulta nuestro repositorio de GitHub con ejemplos de código.
Publicado también en
También publicado en dev.to (en inglés).
Empieza a usar la API
Una sola suscripción de US$15 al mes cubre todas las API de useapi.net: un token para todos los servicios. Conectas hasta 3 cuentas propias por servicio, cada una con la suscripción de su sitio web, y useapi.net se encarga de la API REST, el balanceo de carga y el polling. ¿Necesitas más cuentas? Cada suscripción adicional cuesta US$10 al mes y suma 3 cuentas más por servicio.
Suscríbete — US$15/mes Pagar con cripto
¿No tienes una tarjeta de crédito internacional? También puedes suscribirte con criptomonedas (los pagos con cripto no se reembolsan). Los precios y los planes por volumen están en la página de suscripción. Si pagas con Stripe, recibes el reembolso completo dentro de los 14 días posteriores a la primera compra, si tienes menos de 50 generaciones exitosas. ¿Ya tienes una suscripción? Cambia la cantidad en el portal de clientes de Stripe en lugar de volver a comprar.