Como fazer um vídeo UGC de produto com a Google Flow API
8 min de leitura • 4 de setembro de 2026 (6 de novembro de 2026)
A useapi.net é uma API de terceiros. Não tem afiliação com o Google nem é endossada por ele.
Sumário
- Introdução
- Preços
- Sobre os ids nas requisições
- Etapa 1: uma ficha para cada produto
- Etapa 2: a apresentadora
- Etapa 3: o quadro fixo, a cena inteira num só quadro
- Etapa 4: um clipe por produto, todos a partir do quadro fixo
- Etapa 5: upscale para 1080p
- Etapa 6: juntar os clipes
- O que esperar
- Quanto custou
- Rode você mesmo
- Perguntas frequentes
- Conclusão
Introdução
Um vídeo UGC de produto pode ser feito do começo ao fim pela Google Flow API da useapi.net por 45 créditos do Flow, sem nada processado localmente. Uma apresentadora inventada mostra três produtos inventados para a câmera.
UGC é o estilo de conteúdo gerado por usuários que enche os feeds das redes sociais e as bibliotecas de anúncios: uma pessoa falando para a câmera do celular, para vender um produto, para divertir ou só por diversão.
Este é o guia completo, de A a Z, para produzir esse tipo de vídeo com nível profissional: os produtos, a apresentadora, as falas dela e o corte final, tudo sob seu controle, em seis etapas de chamadas de API que você pode copiar como estão. Prefere um formulário sem código? O fluxo de anúncios UGC no n8n (em inglês) cria esse tipo de anúncio com uma página para escolher ou gerar de novo em cada etapa.
Aqui está o resultado: três clipes Omni 1.1 Flash de 10 segundos com upscale para 1080p, cada quadro e cada som gerados pela Google Flow API. A mesma chamada de upscale chega a 4K quando você precisa de qualidade profissional, veja a Etapa 5:
45 créditos no total
Se você prefere assistir em vez de ler, aqui está o guia inteiro em 75 segundos (em inglês):
assistir no YouTube · narração e música da MiniMax API
Preços
Vídeo com o Omni 1.1 Flash exige uma assinatura paga do Google AI (Plus, Pro ou Ultra), e a useapi.net não cobra nada por vídeo. Quanto este vídeo custou, etapa por etapa, está em Quanto custou, e o preço por vídeo em cada plano, comparado com a API oficial, está na tabela de preços do Google Flow.
Sobre os ids nas requisições
Cada requisição abaixo se refere a resultados anteriores pelo mediaGenerationId. Os ids são longos, então aparecem encurtados aqui como user:1234-email:…-image:b0bdf3e8-…, e uma linha abaixo de cada requisição diz a qual resultado anterior cada um corresponde. O id de uma imagem vem do POST /images em media[0].image.generatedImage.mediaGenerationId, o de um personagem no campo character do POST /characters, o de um vídeo em media[0].mediaGenerationId do job concluído, e o id de um clipe com upscale é o id de origem com _upsampled no final.
Etapa 1: uma ficha para cada produto
Uma ficha de produto é uma única imagem que mostra o item por quatro lados, para que o modelo tenha o objeto inteiro e não um ângulo de sorte. POST /images, quadrado, uma requisição por produto. O prompt descreve a câmera de cada painel, porque só “frente, lado, costas” deu dois painéis idênticos para a caneca e nenhum lado de verdade para o teclado. Um objeto achatado como o teclado precisa de um painel visto de cima, um em forma de cubo não. Sem mãos, sem legendas, sem logos, para que nada além do produto vaze para os clipes.
O mesmo funciona com um produto real. Envie fotos dele com POST /assets e passe os ids como reference_1 a reference_4 nesta requisição, e o modelo transforma tudo numa ficha limpa de quatro painéis. O mesmo truque faz uma ficha de uma embalagem, de um logo ou de um kit.
curl — POST /images (a caneca)
curl --location 'https://api.useapi.net/v1/google-flow/images' \
--header 'Authorization: Bearer user:1234-…' \
--form 'email="[email protected]"' \
--form 'aspectRatio="1:1"' \
--form 'count="2"' \
--form 'prompt="Orthographic product-catalog sheet on a plain white background: a matte white ceramic mug with a straight cylindrical body and a clearly visible glowing amber light band around its base, about a finger wide, like a smart heated mug. The sheet is divided into four equal panels by thin grey lines in a 2 by 2 grid. Every panel shows the same single item at exactly the same size, position and lighting, camera at the item'\''s eye level unless stated: top-left: side profile, the handle pointing left and seen edge-on; top-right: view from the handle side, the handle pointing straight at the camera; bottom-left: view from the opposite side, the handle hidden behind the body; bottom-right: three-quarter view from slightly above, the handle to the right. Soft even studio light, photoreal. Object only: no hands, no people, no props, no text anywhere, no captions, no labels, no logo, no packaging."'
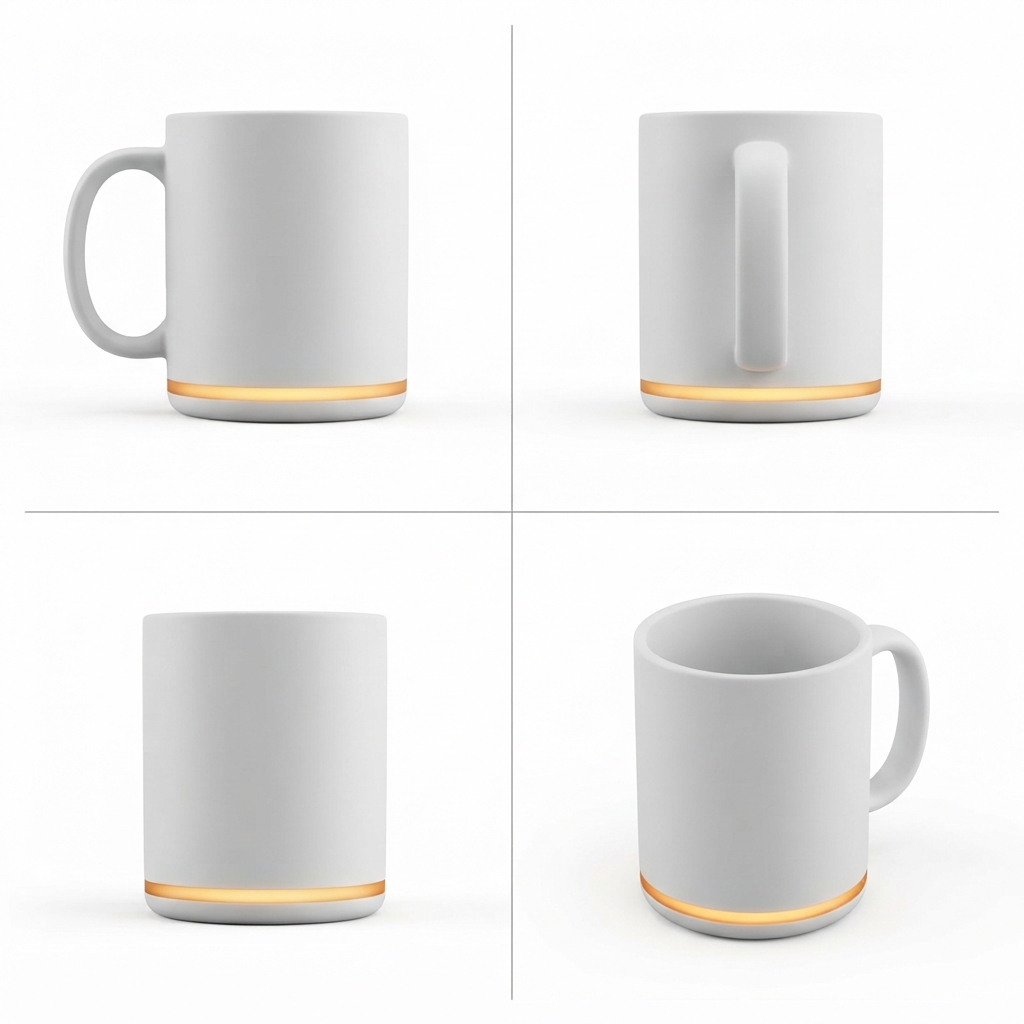
b0bdf3e80 créditos
curl — POST /images (o robô de mesa)
curl --location 'https://api.useapi.net/v1/google-flow/images' \
--header 'Authorization: Bearer user:1234-…' \
--form 'email="[email protected]"' \
--form 'aspectRatio="1:1"' \
--form 'count="2"' \
--form 'prompt="Orthographic product-catalog sheet on a plain white background: a small rounded pastel mint desk robot, a palm-sized cube with a glossy black screen face showing a happy smiling expression, two round white eyes and a curved white smile, a little rounded antenna nub on top, a small round white dial on its right side, and a speaker grille on its back. The sheet is divided into four equal panels by thin grey lines in a 2 by 2 grid. Every panel shows the same single item at exactly the same size, position and lighting, camera at the item'\''s eye level unless stated: top-left: front view showing the smiling face; top-right: right side view showing the round dial and the antenna nub; bottom-left: back view showing the speaker grille; bottom-right: three-quarter view showing the smiling face and the dial. Soft even studio light, photoreal. Object only: no hands, no people, no props, no text anywhere, no captions, no labels, no logo, no packaging."'
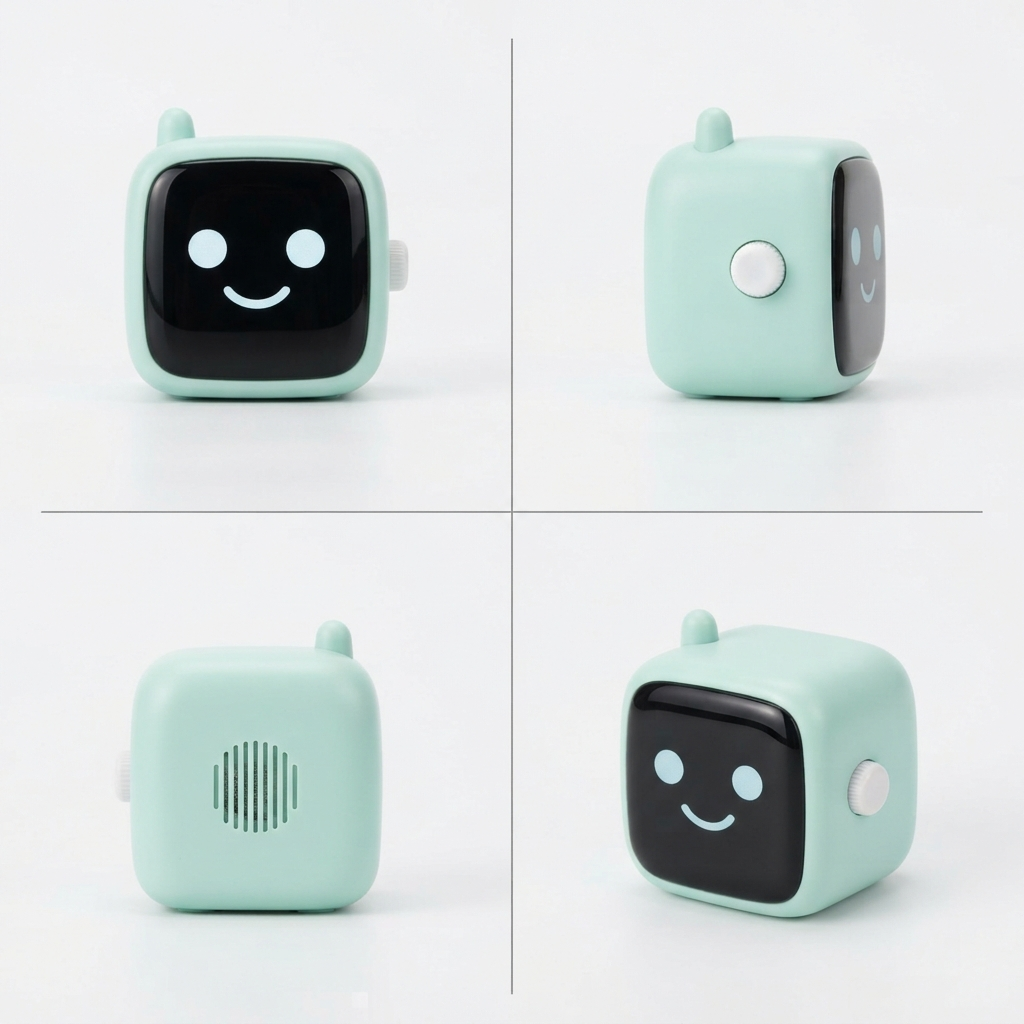
7aaed0560 créditos
curl — POST /images (o teclado)
curl --location 'https://api.useapi.net/v1/google-flow/images' \
--header 'Authorization: Bearer user:1234-…' \
--form 'email="[email protected]"' \
--form 'aspectRatio="1:1"' \
--form 'count="4"' \
--form 'prompt="Orthographic product-catalog sheet on a plain white background: a real mechanical three-key macro pad, the kind sold for shortcuts: a slim, low-profile white aluminum case, three mechanical key switches in one row with sculpted dished keycaps and a small gap between them, coral on the left, lemon yellow in the middle, sky blue on the right, a USB-C port on the back edge. Exactly three keys in one row, never more. The sheet is divided into four equal panels by thin grey lines in a 2 by 2 grid. Every panel shows the same single item at exactly the same size, position and lighting, camera at the item'\''s eye level unless stated: top-left: top-down view straight from above, the three keys in a row left to right; top-right: front view at eye level; bottom-left: left side view at eye level, the slim case and the keycap profile seen edge-on; bottom-right: three-quarter view from above. Soft even studio light, photoreal. Object only: no hands, no people, no props, no text anywhere, no captions, no labels, no logo, no packaging."'
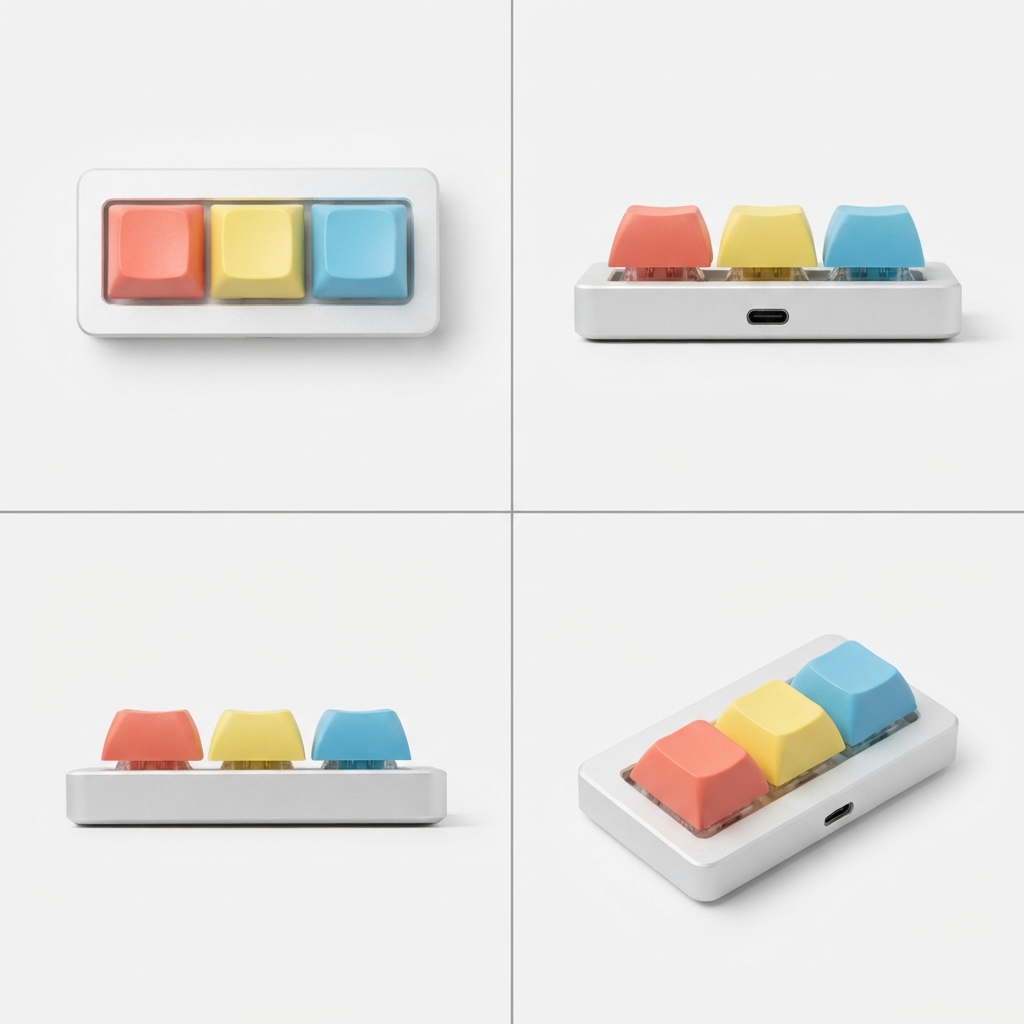
4f861c230 créditos
Imagens não custam nada, então peça count de 2 a 4 e fique com a melhor ficha. O teclado levou algumas rodadas até o prompt descrever um macro pad de verdade com um painel visto de cima, o cubo funcionou de primeira.
Etapa 2: a apresentadora
Três chamadas. Um retrato de frente a partir de uma descrição. Um retrato em três quartos gerado a partir do primeiro com reference_1, para que os dois tenham o mesmo rosto. Depois POST /characters com os dois retratos, que devolve uma referência de personagem. A partir daí ela é @character_1 em qualquer prompt, e o Google a fixa pelo próprio sistema de entidades em vez de por uma descrição.
curl — POST /images (retrato de frente)
curl --location 'https://api.useapi.net/v1/google-flow/images' \
--header 'Authorization: Bearer user:1234-…' \
--form 'email="[email protected]"' \
--form 'aspectRatio="3:4"' \
--form 'count="2"' \
--form 'prompt="Character reference portrait, photoreal, natural skin, no heavy retouching: a strikingly attractive young woman in her early twenties with a sleek platinum-blonde blunt bob and straight bangs, dark defined eyebrows, icy grey eyes, a tiny silver nose stud, a playful smirk with a hint of teeth, wearing a fitted black turtleneck and a thin gold chain necklace. Head and shoulders, facing the camera straight on, plain light-grey studio background, soft even light. No text, no logo, no captions."'
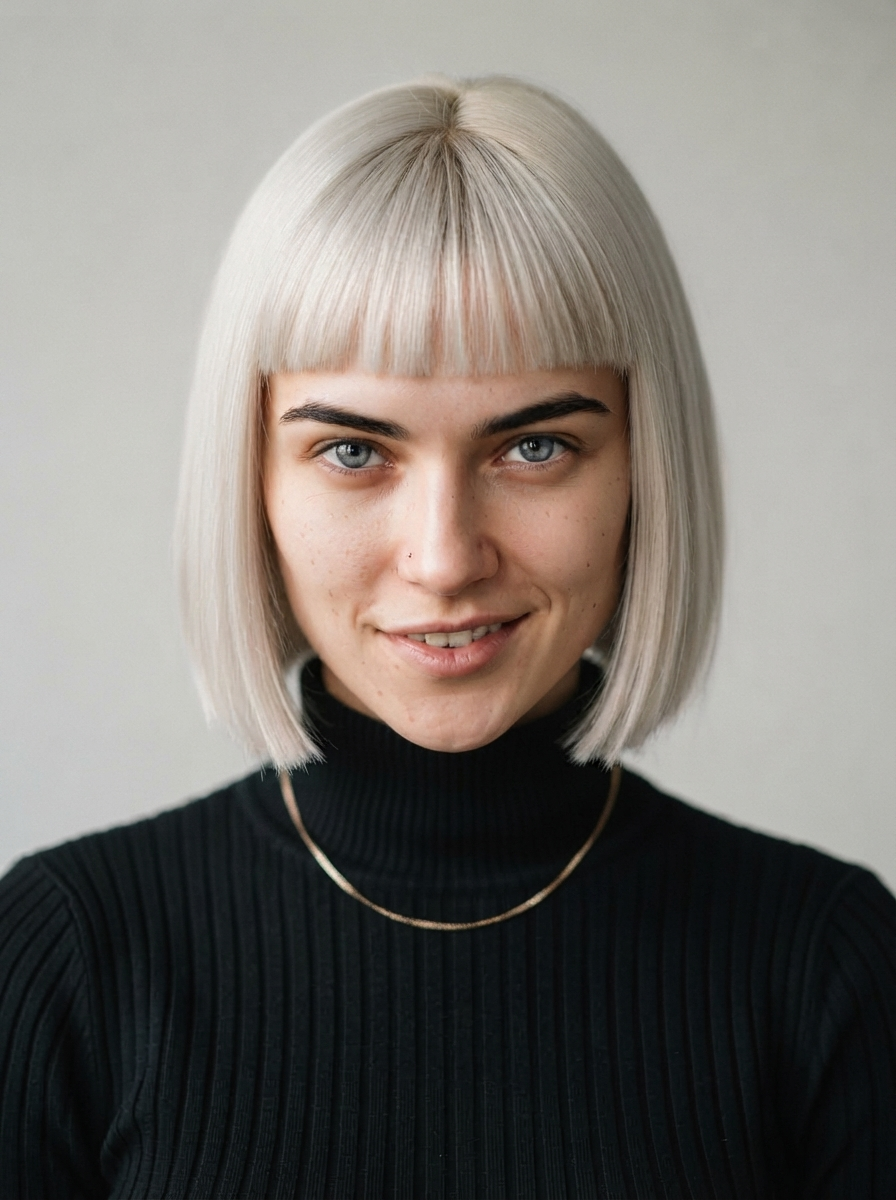
a236ef660 créditos
Geramos alguns visuais e escolhemos este. Se algum detalhe precisar mudar depois, a corrente, por exemplo, gere-a de novo com o próprio retrato dela como reference_1 e um prompt que cite só a mudança, e o rosto continua o mesmo.
curl — POST /images (retrato em três quartos)
curl --location 'https://api.useapi.net/v1/google-flow/images' \
--header 'Authorization: Bearer user:1234-…' \
--form 'email="[email protected]"' \
--form 'aspectRatio="3:4"' \
--form 'count="1"' \
--form 'reference_1="user:1234-email:…-image:a236ef66-…"' \
--form 'prompt="@reference_1 is the same woman: identical face, hair, freckles, sweater and earrings. Three-quarter view from the waist up, relaxed natural smile, plain light-grey studio background, soft even light. Photoreal, no text."'
reference_1 é o retrato de frente, a236ef66. Este prompt ainda menciona sardas, um suéter e brincos que sobraram de uma apresentadora anterior, e isso não atrapalhou: com uma imagem de referência na requisição, a referência vence as palavras.
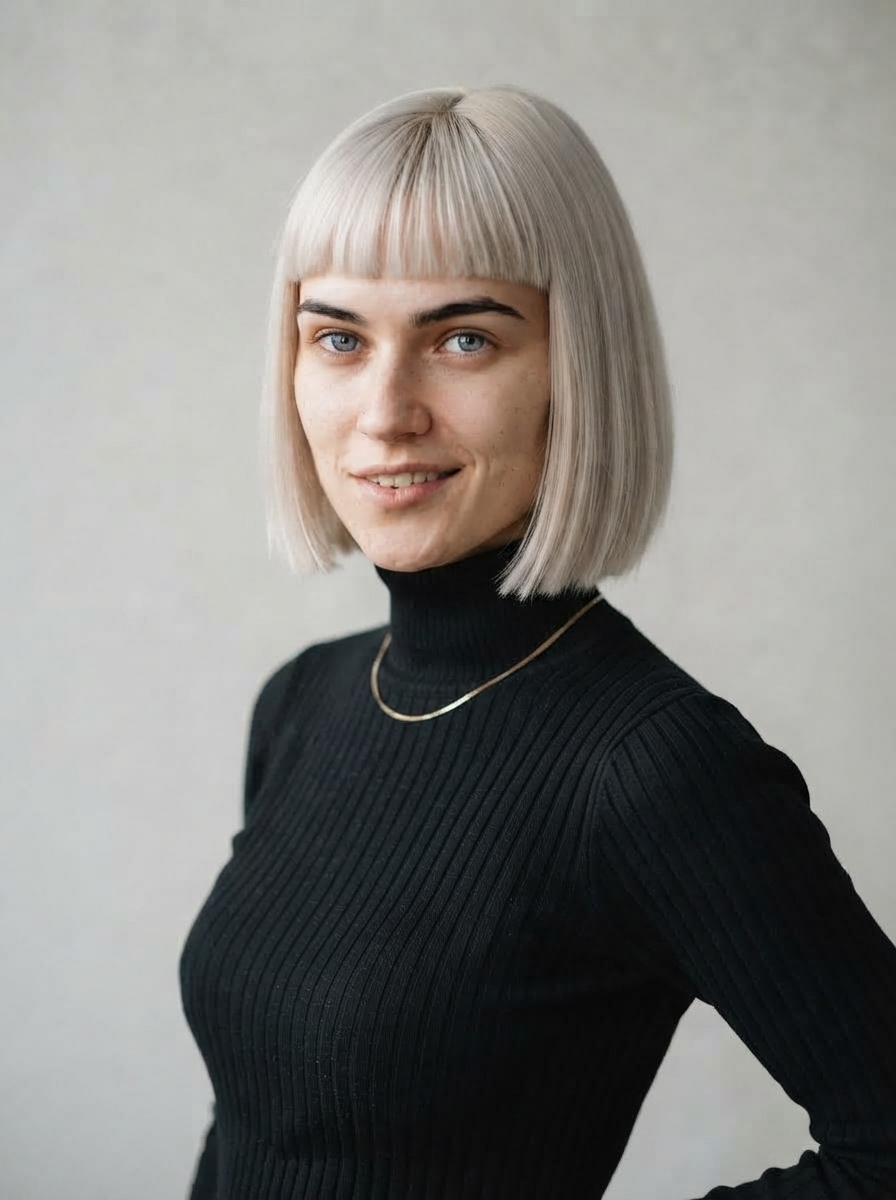
d891301c0 créditos
curl — POST /characters
curl --location 'https://api.useapi.net/v1/google-flow/characters' \
--header 'Authorization: Bearer user:1234-…' \
--form 'displayName="Mia"' \
--form 'personalityNotes="Quick, bright, deadpan delivery with a smile in her voice. Talks to the camera like a friend showing off things she bought at 2am."' \
--form 'imageReference_1="user:1234-email:…-image:a236ef66-…"' \
--form 'imageReference_2="user:1234-email:…-image:d891301c-…"' \
--form 'voice="Leda"'
imageReference_1 é o retrato de frente a236ef66, imageReference_2 o de três quartos d891301c. O campo character da resposta é o id dela, 53ca1036 abaixo. A voice é um dos presets de sistema do Google e vai junto com a personagem, mas não chega ao modo de clipe usado na Etapa 4, veja O que esperar.
Etapa 3: o quadro fixo, a cena inteira num só quadro
Uma requisição junta tudo. A personagem entra como character_1, as três fichas como reference_1 a reference_3, e o prompt posiciona cada uma pela tag, da esquerda para a direita na mesa à frente dela. Este quadro vira as duas pontas de cada clipe, então é o único lugar onde as tags fazem o trabalho.
curl — POST /images
curl --location 'https://api.useapi.net/v1/google-flow/images' \
--header 'Authorization: Bearer user:1234-…' \
--form 'email="[email protected]"' \
--form 'aspectRatio="9:16"' \
--form 'count="2"' \
--form 'character_1="user:1234-email:…-character:53ca1036-…"' \
--form 'reference_1="user:1234-email:…-image:b0bdf3e8-…"' \
--form 'reference_2="user:1234-email:…-image:7aaed056-…"' \
--form 'reference_3="user:1234-email:…-image:4f861c23-…"' \
--form 'prompt="Full-frame vertical phone video look, no phone, no bezel. @character_1 sits at a light wooden table in a bright minimal creator studio, facing the camera, waist-up and centered, a plain warm-grey backdrop behind her, soft key light from the left with a gentle catchlight in her eyes. Laid out on the table in front of her, left to right, each fully visible and resting flat on the table: the mug from @reference_1, the desk robot from @reference_2, the keyboard from @reference_3. Her hands rest on the table, relaxed closed-mouth smile, eyes on the lens. Photoreal, no text, no captions."'
character_1 é a personagem da Etapa 2, 53ca1036. reference_1 a reference_3 são as três fichas da Etapa 1: a caneca b0bdf3e8, o robô de mesa 7aaed056, o teclado 4f861c23.
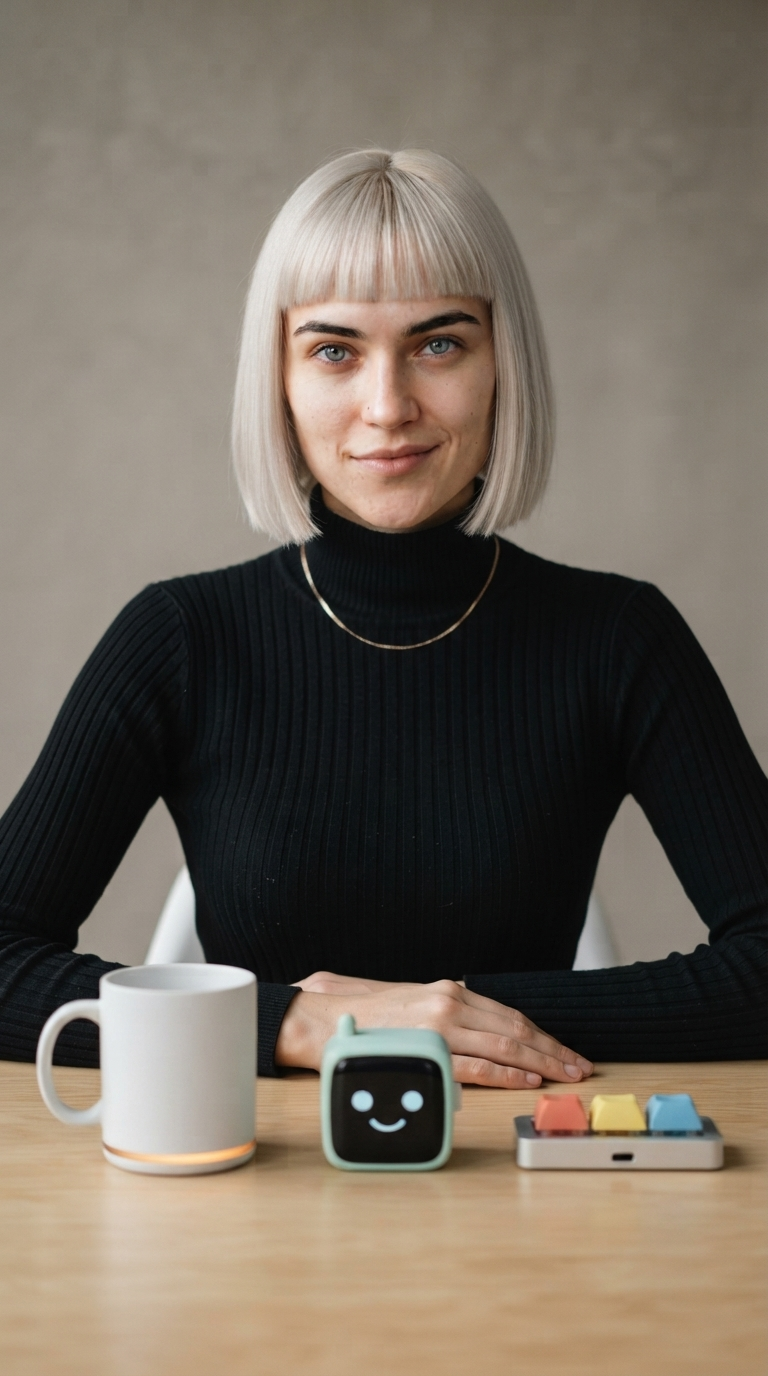
034cddc80 créditos
A caneca tem o brilho, o robô tem o rosto e a antena, o teclado tem as três cores e a porta, e ela é a mulher dos retratos.
Etapa 4: um clipe por produto, todos a partir do quadro fixo
O modo de primeiro e último quadro do Omni, com o quadro fixo nas duas posições, uma requisição por produto, o mesmo POST /videos toda vez. Esse modo aceita só as duas imagens, sem fichas, sem personagem, sem referência de voz. Tudo bem, porque o quadro fixo já tem tudo isso. Cada item que ela pega saiu igual à ficha só a partir do quadro fixo.
O prompt faz três coisas. Prende as duas pontas ao quadro, com uma pausa calma de cada lado. Dá a ela a fala e a voz. E marca o tempo da coreografia: ela começa a falar enquanto levanta o item, o item volta ao lugar até a marca de oito segundos, e os dois últimos segundos são uma pausa parada e em silêncio. Sem essa última parte, ela se atrasava e o braço saltava para o quadro final.
curl — POST /videos (a caneca)
curl --location 'https://api.useapi.net/v1/google-flow/videos' \
--header 'Authorization: Bearer user:1234-…' \
--form 'email="[email protected]"' \
--form 'model="omni-flash"' \
--form 'aspectRatio="portrait"' \
--form 'duration="10"' \
--form 'resolution="720p"' \
--form 'startImage="user:1234-email:…-image:034cddc8-…"' \
--form 'endImage="user:1234-email:…-image:034cddc8-…"' \
--form 'prompt="She begins and ends exactly on this frame: hands resting on the table, the three items laid out in front of her, a small closed-mouth smile, looking into the lens, with a short quiet beat before she moves and another after she settles back. Timing matters: after a short quiet beat she picks up the mug on the left with both hands and starts talking as she lifts it, holding it up to the camera and talking straight to the lens, quick and bright with a deadpan edge and a smile in her voice, keeping both hands on the mug while she speaks. She says: \"Three gadgets smarter than me. Low bar. One: this mug texts me when my coffee'\''s cold. Better follow-up than my ex.\" Right after the last word she gives one short laugh to herself, still holding the mug. By the eight-second mark the mug is back down gently in exactly the same spot and both hands are resting on the table again, brought back in one calm unhurried movement. For the final two seconds she holds completely still, hands resting on the table, looking into the lens with a small closed-mouth smile. Natural room tone, no music, no captions, no text on screen."'
startImage e endImage são ambos o quadro fixo da Etapa 3, 034cddc8. Os mesmos dois ids vão nos três clipes.
55808825, mostrado após o upscale para 1080p da Etapa 515 créditos
curl — POST /videos (o robô de mesa)
curl --location 'https://api.useapi.net/v1/google-flow/videos' \
--header 'Authorization: Bearer user:1234-…' \
--form 'email="[email protected]"' \
--form 'model="omni-flash"' \
--form 'aspectRatio="portrait"' \
--form 'duration="10"' \
--form 'resolution="720p"' \
--form 'startImage="user:1234-email:…-image:034cddc8-…"' \
--form 'endImage="user:1234-email:…-image:034cddc8-…"' \
--form 'prompt="She begins and ends exactly on this frame: hands resting on the table, the three items laid out in front of her, a small closed-mouth smile, looking into the lens, with a short quiet beat before she moves and another after she settles back. Timing matters: after a short quiet beat she picks up the desk robot in the middle with both hands and starts talking as she lifts it, holding it up to the camera with its smiling face toward the lens and turning it once and talking straight to the lens, quick and bright with a deadpan edge and a smile in her voice, keeping both hands on it while she speaks. The other two items stay on the table exactly where they are. She says: \"Two: a desk robot that reacts to my day. It has a face. It has never once looked impressed.\" Right after the last word she raises one eyebrow at the camera, a quick expressive beat, still holding the desk robot. By the eight-second mark the desk robot is back down gently in exactly the same spot and both hands are resting on the table again, brought back in one calm unhurried movement. For the final two seconds she is silent and holds completely still, hands resting on the table, looking into the lens with a small closed-mouth smile. Natural room tone, no music, no captions, no text on screen."'
c4d0e6b1, mostrado após o upscale para 1080p da Etapa 515 créditos
curl — POST /videos (o teclado)
curl --location 'https://api.useapi.net/v1/google-flow/videos' \
--header 'Authorization: Bearer user:1234-…' \
--form 'email="[email protected]"' \
--form 'model="omni-flash"' \
--form 'aspectRatio="portrait"' \
--form 'duration="10"' \
--form 'resolution="720p"' \
--form 'startImage="user:1234-email:…-image:034cddc8-…"' \
--form 'endImage="user:1234-email:…-image:034cddc8-…"' \
--form 'prompt="She begins and ends exactly on this frame: hands resting on the table, the three items laid out in front of her, a small closed-mouth smile, looking into the lens, with a short quiet beat before she moves and another after she settles back. Timing matters: after a short quiet beat she picks up the keyboard on the right with both hands and starts talking as she lifts it, holding it up to the camera with the three keys facing the lens and talking straight to the lens, quick and bright with a deadpan edge and a smile in her voice, keeping both hands on it while she speaks. The other two items stay on the table exactly where they are. She says: \"Three: a keyboard with three keys. Copy, paste, undo. That'\''s my whole career. Oh, the mug'\''s texting. Bye!\" Right after the last word she raises one eyebrow at the camera, a quick expressive beat, still holding the keyboard. By the eight-second mark the keyboard is back down gently in exactly the same spot and both hands are resting on the table again, brought back in one calm unhurried movement. For the final two seconds she is silent and holds completely still, hands resting on the table, looking into the lens with a small closed-mouth smile. Natural room tone, no music, no captions, no text on screen."'
3cc8ea2f, mostrado após o upscale para 1080p da Etapa 515 créditos
A mesma mulher, a mesma mesa, a mesma luz, e cada clipe abre e fecha no quadro fixo, então qualquer um pode vir depois de qualquer outro. As falas têm cerca de 20 palavras em inglês, o que cabe em 10 segundos neste ritmo, com espaço para a pausa no final.
Etapa 5: upscale para 1080p
O Omni 1.1 Flash renderiza em 720p. O POST /videos/upscale leva um clipe a 1080p de graça em qualquer plano pago, em cerca de 40 segundos, e responde na mesma chamada com o id e a URL do clipe com upscale. Uma requisição por clipe, sem email: a conta vem do id.
curl — POST /videos/upscale (a caneca, depois o mesmo para os outros dois)
curl --location 'https://api.useapi.net/v1/google-flow/videos/upscale' \
--header 'Authorization: Bearer user:1234-…' \
--form 'mediaGenerationId="user:1234-email:…-video:55808825-…"' \
--form 'resolution="1080p"'
mediaGenerationId é o clipe da caneca da Etapa 4, 55808825. A mesma chamada com c4d0e6b1 e 3cc8ea2f faz o upscale do robô e do teclado. Cada resposta traz o novo clipe em media[0].mediaGenerationId, que é o id de origem com _upsampled no final, então os três ids com upscale são 55808825-…_upsampled, c4d0e6b1-…_upsampled e 3cc8ea2f-…_upsampled. Os clipes mostrados na Etapa 4 são essas versões com upscale. 4K também está disponível, por 50 créditos e só num plano Google AI Ultra.
Etapa 6: juntar os clipes
O POST /videos/concatenate recebe os três ids com upscale em ordem e devolve o arquivo unido em base64, na resolução dos clipes. Os cortes decidem se as emendas parecem uma tomada só. Cada clipe abre com uma pausa curta no quadro fixo e fecha voltando a ele, e sem corte essas pausas se acumulam num congelamento a cada emenda. Mas ela termina cada fala já com as mãos apoiadas, então um corte medido só pela imagem come as últimas palavras. Corte depois do último som mais uma pausa, nunca antes. Nestes clipes, isso significou deixar o clipe 1 inteiro, já que a risada vai até o último quadro, tirar pouco mais de meio segundo do fim do clipe 2 e alguns quadros do início dos clipes 2 e 3.
curl — POST /videos/concatenate
curl --location 'https://api.useapi.net/v1/google-flow/videos/concatenate' \
--header 'Authorization: Bearer user:1234-…' \
--header 'Content-Type: application/json' \
--data '{
  "media": [
    { "mediaGenerationId": "user:1234-email:…-video:55808825-…_upsampled" },
    { "mediaGenerationId": "user:1234-email:…-video:c4d0e6b1-…_upsampled", "trimStart": 0.458, "trimEnd": 0.6 },
    { "mediaGenerationId": "user:1234-email:…-video:3cc8ea2f-…_upsampled", "trimStart": 0.125 }
  ]
}'
Os três ids são os clipes com upscale da Etapa 5, em ordem: a caneca, o robô de mesa, o teclado.
0 créditos
Ela termina uma fala com as mãos na mesa, o corte entra e ela pega o próximo item. O arquivo unido foi recodificado num tamanho menor para hospedagem, os três clipes estão como a API os devolveu.
O que esperar
- Gere, não edite. O post UGC talking head (em inglês) estendeu um clipe com edições de vídeo para vídeo, e isso ainda funciona quando as falas são curtas. Aqui não funcionou. Uma edição mantém a fala da origem na linha do tempo da própria origem, então, com uma fala de 10 segundos ocupando o clipe de partida, a nova fala se misturou à antiga em vez de substituí-la, e os produtos deixados na mesa mudaram entre as tomadas. Gerar cada clipe a partir do quadro fixo deu falas completas, produtos intactos e emendas mais limpas, por menos créditos.
- O quadro fixo carrega as tags. O modo de primeiro e último quadro aceita só as duas imagens. Faça as tags no quadro fixo, com a personagem e as fichas, e os clipes herdam tudo.
- Marque o tempo da coreografia. Um clipe de 10 segundos com uma fala completa precisa que o momento de pousar o item seja marcado pelo relógio, “by the eight-second mark” (até a marca de oito segundos), e uma pausa parada e em silêncio no final. Por conta própria, o modelo esticava a fala e saltava para o quadro final.
- Descreva a voz do mesmo jeito em todos os prompts. Nada leva uma voz de um clipe para outro, e uma personagem pode guardar um preset de voz, mas não alcança este modo. Com uma descrição idêntica, os três clipes saíram parecidos o bastante para passar por uma tomada só.
- As fichas precisam de câmera por painel. Diga o que cada um dos quatro painéis mostra. Dê a objetos achatados um painel visto de cima. Deixe mãos, legendas e logos de fora, porque o que estiver na ficha pode acabar no clipe.
- Corte pelo som, não pela imagem. Ela fica parada antes de parar de falar. Um corte no primeiro quadro parado levou junto o fim de uma fala.
- A apresentadora é inventada. A moderação do Google é mais rígida com pessoas reais e identificáveis. Comece com uma personagem gerada.
Quanto custou
| Etapa | Modo | Créditos |
|---|---|---|
| Três fichas de produto, 1:1 | Nano Banana 2 Lite | 0 |
| Dois retratos da apresentadora, 3:4 | Nano Banana 2 Lite | 0 |
| A personagem | — | 0 |
| O quadro fixo, 9:16 | Nano Banana 2 Lite, personagem + 3 referências | 0 |
| Clipe 1, a caneca, 10s | I2V, primeiro + último quadro | 15 |
| Clipe 2, o robô de mesa, 10s | I2V, primeiro + último quadro | 15 |
| Clipe 3, o teclado, 10s | I2V, primeiro + último quadro | 15 |
| Upscale, três clipes para 1080p | — | 0 |
| Concatenar | — | 0 |
| Total | 45 |
Imagens, personagens, o upscale para 1080p e a concatenação não custam nada, então refaça à vontade as fichas, a apresentadora e o quadro fixo antes de gastar um crédito com vídeo. O 4K é o único upgrade pago, 50 créditos por clipe no Ultra.
Rode você mesmo
Cada etapa acima é uma chamada de API, e as seis se encadeiam num script. O pipeline completo em Node.js, uma versão em Python e o prompts.json com todos os prompts desta página estão em useapi/google-flow-api/ugc-product-video. Clone, coloque seus próprios produtos e falas no prompts.json, e um único comando monta o vídeo inteiro.
Ele salva um checkpoint após cada etapa, então uma execução interrompida continua de onde parou em vez de pagar pelos clipes de novo, e você pode refazer uma única etapa — um quadro fixo melhor, outra apresentadora — sem gerar de novo o que veio antes.
Perguntas frequentes
- Posso usar fotos do meu próprio produto em vez de fichas geradas? Pela useapi.net, sim. Envie as fotos com POST /assets e passe os ids retornados como
reference_1areference_3no quadro fixo, exatamente como as fichas geradas são passadas aqui. A ficha de quatro painéis é uma forma de dar ao modelo todos os lados de um objeto, e um produto real ganha com o mesmo tratamento. - Por que não editar um clipe para virar o próximo, como no post do talking head (em inglês)? Pela useapi.net dá para fazer, mas uma edição de vídeo para vídeo mantém a fala da origem na linha do tempo da origem. Com falas curtas, funciona. Com uma fala de 10 segundos ocupando o clipe, a nova fala se misturou à antiga e os produtos na mesa mudaram. Gerar todos os clipes a partir do mesmo quadro fixo evita os dois problemas e custa 15 créditos em vez de 20. Veja O que esperar.
- Por que os três clipes começam e terminam no mesmo quadro? Pela useapi.net, o modo de primeiro e último quadro prende as duas pontas de cada clipe ao mesmo quadro fixo, então os clipes se juntam em qualquer ordem sem corte visível, e a chamada de concatenação corta as pausas curtas em cada emenda. O mecanismo está explicado no post UGC talking head (em inglês).
- A voz fica igual entre os clipes? Pela useapi.net, os três clipes saíram parecidos o bastante para passar por uma tomada só, porque a voz foi descrita de forma idêntica em todos os prompts. O modo de primeiro e último quadro não aceita referência de áudio, e o preset de voz de uma personagem não chega até ele. Se você precisa de uma voz garantida, o modo de referência para vídeo aceita
referenceAudio_1, ao custo dos quadros fixados. - Quanto custa? Pela useapi.net, este vídeo inteiro de 29 segundos custa $0,36 no Google AI Ultra $199,99: 45 créditos do Flow para os três clipes Omni 1.1 Flash, com todas as imagens, retratos, a personagem e a concatenação de graça. Os mesmos 30 segundos de Omni 1.1 Flash em 720p custam cerca de $3,04 na Gemini API oficial (em novembro de 2026). Veja Quanto custou.
Conclusão
Visite o nosso  servidor no Discord ou o
 canal no Telegram para qualquer dúvida de suporte.
Veja nosso repositório no GitHub com exemplos de código.
Publicado também em
Também publicado no dev.to (em inglês).
Comece a usar a API
Uma assinatura de US$ 15 por mês dá acesso a todas as APIs da useapi.net: um token, todos os serviços. Você conecta até 3 contas suas por serviço, e a useapi.net cuida da API REST, do balanceamento de carga e do polling. Precisa de mais contas? Cada assinatura extra custa US$ 10 por mês e acrescenta mais 3 contas por serviço.
Assinar — US$ 15/mês Pagar com cripto
Não tem cartão de crédito internacional? Você também pode assinar com criptomoedas (pagamentos em cripto não são reembolsáveis). Preços e planos de volume estão na página de assinatura. Pagando pelo Stripe, você recebe reembolso integral em até 14 dias após a primeira compra, se tiver menos de 50 gerações bem-sucedidas. Já é assinante? Altere a quantidade no portal do cliente Stripe em vez de comprar de novo.